


케이잡스, 한국어 상담 AI 평가 신뢰성 연구 논문 arXiv 공개… 모델 간 합의도 낮아
김형석 기자
작성일 2026-11-16 18:01
본문
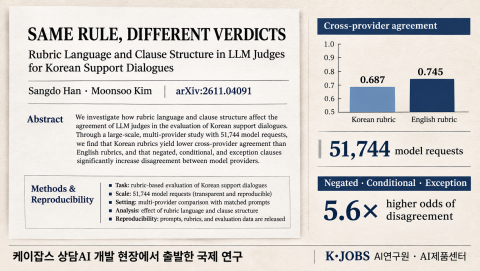
지난 11월 3일, 두 연구자는 'Same Rule, Different Verdicts: Rubric Language and Clause Structure in LLM Judges for Korean Support Dialogues'라는 제목의 논문을 국제 공개 연구 플랫폼 arXiv에 발표했다. 이 논문은 케이잡스가 한국어 기반 자율상담 서비스를 개발하고 품질을 점검하는 과정에서 제기된 문제의식에서 출발했다.
연구진은 상담자의 행동을 평가하는 12개 기준을 긍정형, 부정형, 조건형, 예외형의 네 가지 문장 구조로 구성하고, 이를 한국어와 영어로 각각 제시했다. 이후 총 5만 1744건의 평가를 6개 저비용 모델과 1개 참고 모델에 요청했다.
분석 결과, 한국어 평가 기준에서 모델 간 판정 합의도를 나타내는 코헨의 카파(Cohen’s kappa)는 0.687로, 영어 평가 기준(0.745)보다 낮게 나타났다. 이는 한국어 평가 기준에서 모델 간 합의도가 더 낮았음을 의미한다.
또한, 부정형·조건형·예외형 기준에서 모델 간 불일치 오즈는 긍정형보다 평균 5.6배 높았다. 의미가 같은 기준이라도 문장 구조만 바꿔 제시했을 때 약 11~15%의 모델이 판정을 바꾸는 사례가 발생했다.
이번 연구는 한국어 LLM 평가에서 어떤 모델을 사용하는가뿐 아니라, 평가 기준을 어떤 언어와 문장 구조로 작성하는가도 판정의 일관성에 영향을 미칠 수 있음을 수치로 제시했다는 점에서 기여하는 바가 크다. 연구진은 평가 기준을 명확한 긍정형 문장으로 작성하고, 부정·조건·예외가 포함된 항목은 복수 모델을 이용한 일관성 점검을 거칠 것을 제안했다.
케이잡스는 이번 연구 결과를 자율상담 서비스의 평가 기준 설계와 품질 점검에 적용하여, 복잡한 조건이 포함된 기준은 여러 모델의 판정을 비교하는 등 AI 상담의 품질 관리를 과학적으로 고도화할 계획이다.
한편, 이번 논문은 상담 AI의 효과나 안전성을 입증한 연구가 아니라 LLM 평가 판정의 일관성을 측정한 연구이며, 현재 동료 평가 전 공개된 arXiv 프리프린트 상태다.
기사 공유하기
추천 0
