


중앙대 연구팀, AI 객관식 문제 '위치 편향' 원인 규명…학계 발표
김형석 기자
작성일 2026-11-22 18:02
본문
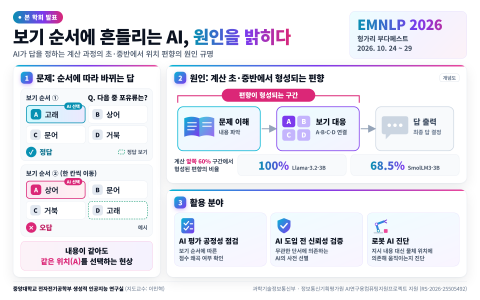
지금까지 AI의 객관식 문제 평가 시, 정답 위치에 따라 AI가 틀리는 현상에 대해 보기 순서를 여러 번 바꿔 점수를 평균 내는 방식으로 대응해왔으나, 그 근본적인 원인은 밝혀지지 않았다. 연구팀은 AI가 문제를 이해하고 답을 도출하기까지 수십 단계에 걸친 계산 과정을 분석했다. 그 결과, 특정 위치를 선호하는 편향은 AI의 계산 과정 후반이 아닌 초·중반, 즉 계산의 앞쪽 60% 구간에서 이미 형성됨을 확인했다. 실험에 사용된 Llama-3.2-3B 모델의 경우 100%가 이 구간에서 편향이 나타났으며, SmolLM3-3B 모델에서도 68.5%가 해당 구간에서 발생했다.
연구팀은 AI가 계산 초반에 문제 내용을 파악하고 중반에 보기와 연결하는 과정에서 위치 편향이 함께 확정된다고 설명했다. 이 편향이 정답 선택 계산 과정에 섞여 있어, 기존의 점수 평균화 방식으로는 겉으로 보이는 점수만 안정시킬 뿐 편향 자체를 해소하지 못한다는 것이다. 연구팀은 정답 선택 능력은 유지하면서 편향만 바로잡을 수 있는 AI 내부의 세부 요소 후보도 도출했다고 밝혔다.
이번 분석 방법은 AI 도입 전 시험 점수의 공정성을 점검하거나, 로봇 AI가 지시 내용이 아닌 엉뚱한 단서에 반응하는지 확인하는 데 활용될 수 있을 것으로 기대된다. 본 연구는 과학기술정보통신부와 정보통신기획평가원의 ‘AI연구용컴퓨팅지원프로젝트’ 지원으로 수행되었다.
기사 공유하기
추천 0
